整合不同時期與研究領域的變項關係,辨識共同構念、角色變化,以及目前 AIO 規劃可採用的研究見解。
資料基礎:57 筆研究整理紀錄|研究報告修訂稿
摘要
Google AI Overviews(AIO)持續改變搜尋結果的呈現與資訊取用方式。對行銷與內容團隊而言,關鍵問題是:哪些因素具有跨時期的研究基礎,又應如何轉化為目前的操作判斷?本次研究以既有 57 筆研究整理紀錄為資料來源,進行描述性文獻計量、構念正規化、共現分析與跨情境關係比較;其中 40 筆納入主分析,7 筆作為技術與模擬補充,10 筆為方法或非目標結果紀錄。
分析歸納出七個反覆出現的構念群:查詢與任務、來源身分、內容與證據、排序與介面、信任與主觀評估、使用者先備條件,以及平台與觀測情境。這些構念群均涵蓋三個紀錄年份區間,但其解釋對象與角色並不固定。研究焦點由「排序如何引導人的點擊與可信判斷」,逐步擴展為「系統選用哪些來源、答案是否忠於證據,以及使用者是否採納」。來源權威與內容品質也因此分化:具有聲譽、被列為來源,以及真正支持答案主張,是三個不同問題。中介方面,主觀可信評估形成持續可見的解釋路徑,但不同研究並未支持一個通用、固定的信任—可信度順序;調節方面,任務意圖、議題熟悉度與一般 AI 信任提供了具體的條件證據。
實務上,本次研究支持三項優先安排:依實際任務規劃內容;分開處理來源身分與可查證的主張證據;分開判讀「被選為來源」「被忠實引用」「被使用者採納」。 這些安排具有跨研究的概念基礎;特定格式、篇幅或語句能否提升 Google AIO 引用率,仍須由直接的 AIO 實驗確認。本文提出的是構念與關係的證據整合,不是 Google 演算法權重表。
關鍵詞: AI Overviews、文獻計量、構念正規化、主題演進、中介、調節
一、研究動機:現在的 AIO 操作,需要哪些持續有效的知識?
搜尋研究長期關注排名、內容相關性、來源權威與使用者信任。生成式搜尋出現後,這些問題沒有全部消失,卻增加了新的環節:搜尋引擎不只排列網頁,也會選取來源、組織主張,並在結果頁直接提供答案。因此,同樣寫成「品質影響成效」,可能分別指內容影響排名、來源影響人的可信判斷,或證據能否支持生成答案。若不拆開這些關係,既有研究很容易被轉述成過度簡化的 AIO 操作建議。
本次研究的目的,是從不同時期、領域與搜尋情境的研究中,辨識可以延續到目前規劃工作的共同構念,並釐清它們如何改變。核心問題有三個:第一,哪些名稱不同的變項其實具有可比較的共同內涵?第二,哪些關係在不同研究中持續出現,而其前因、中介、調節與結果位置如何改變?第三,哪些結論可以支持目前的操作,哪些仍只是有待驗證的推論?
研究採取定期更新的觀點。AIO 的可辨識來源、引用配置與介面會隨技術及使用情境變化;因此,較早的研究可用來辨識問題結構,當期的直接證據則用來界定目前的適用範圍。一次整理不能永久代表後續版本的系統。
二、研究設計與分析方法
2.1 資料範圍與分析單位
本次研究使用〈變數關係圖〉中的 57 筆整理紀錄,保留原始編號、變項標籤、研究描述與關係連線。另有 43 筆待審候選文獻,因重複關係與內容尚未完整核定,未與既有紀錄直接相加。本次研究並非重新執行涵蓋所有資料庫的系統性檢索,因此不將資料集視為整個研究領域的完整母體。
57 筆紀錄共擷取 442 個變項節點出現次數與 392 條關係陳述。依研究對象與結果適切性區分後,40 筆進入主分析,包含傳統搜尋、人類資訊判斷、生成式搜尋比較與 AIO 相關研究;7 筆技術或模擬研究作為補充;10 筆方法或非目標結果紀錄保留於資料索引。主分析並不等於 40 篇真實 Google AIO 實驗,也不等於 40 次相互獨立的重複驗證。
表 1
分析資料的範圍與用途
| 分析層次 | 紀錄數 | 在本次研究中的用途 |
|---|---|---|
| 主分析:傳統搜尋與萃取式結果 | 19 | 辨識意圖、排序、來源與人類判斷的既有關係 |
| 主分析:生成式搜尋比較情境 | 12 | 比較生成答案、引用、平台與使用者反應 |
| 主分析:AIO 相關情境 | 9 | 界定對 Google AIO 較直接的適用範圍,含 AIO 刺激實驗 |
| 技術與模擬補充 | 7 | 提供機制線索與待驗證的操作假設 |
| 方法或非目標結果 | 10 | 保留資料完整性,不計入核心構念覆蓋率 |
| 合計 | 57 | 每筆紀錄僅歸入一個分析層次 |
註。 N = 57。主分析共 40 筆。各分類為本次研究重新判讀;AIO 相關情境包含以 AIO 截圖為刺激的實驗,不全是真實線上系統的介入。待審候選文獻 43 筆未納入。
2.2 構念正規化:合併語意,保留差異
構念統整先判讀原始標籤的定義、測量對象及其所連接的結果,再處理同義名稱。例如,搜尋意圖與查詢意圖可歸入共同的任務需求脈絡;排名、位置與名次可在上位層級對照。但「來源權威」不能直接替換為「使用者信任」,「引用出現」也不能直接替換為「引用正確」。
本次研究採兩層編碼:下位層保留可區分的具體構念,上位層歸納為七個構念群。主分析的 311 個節點出現次數,包含 298 種原始文字標籤,經整理得到 234 種下位標籤;其中也包含結果與方法項目,不能將 234 解讀為已驗證的 AIO 影響因子數。七個上位群是依內容進行的語意分類,並非演算法自動發現的潛在因素或社群。
表 2
構念正規化的語意對照及保留界線
| 上位構念群 | 可納入對照的原始概念 | 必須保留的界線 |
|---|---|---|
| 查詢、任務與決策條件 | 搜尋意圖、查詢形式、議題、任務類型、商品決策條件 | 查詢觸發 AIO,與頁面被引用是不同結果 |
| 來源身分與可信基礎 | 作者權威、贊助者身分、來源聲譽、來源類型、來源角色 | 客觀來源特徵與主觀可信評估分開 |
| 內容特徵與證據品質 | 內容相關性、資訊品質、立場、正確性、主張支持、忠實度 | 相關、正確、可支持及被忠實使用分開 |
| 排序、介面與引用呈現 | 名次、位置、摘要、知識面板、引用標示、答案呈現 | 呈現形式與呈現後的點擊、信任分開 |
| 信任與主觀評估 | 來源/訊息可信度、答案信任、感知品質與相關評價 | 信任與可信度保留下位差異,順序依個別模型 |
| 使用者先備條件 | 先備知識、搜尋經驗、熟悉度、一般 AI 信任 | 使用前的傾向與看過答案後的評估分開 |
| 平台、語言與觀測情境 | 引擎、語言、來源地、裝置、時間、比較條件 | 分組差異不直接視為正式調節效果 |
註。 本表為上位群的對照原則;完整原始標籤與下位構念見本次研究的編碼資料(另行保存)。歸在同一群不表示測量相同,亦不表示變項在所有研究中扮演相同角色。
2.3 跨期計量、共現與關係判讀
時間分析依原始紀錄標示年份切為 2007–2022 年、2023–2024 年與 2025–2026 年,主分析紀錄數分別為 16、5、19。各區間以「出現該構念群的紀錄數/該區間總紀錄數」計算覆蓋率;同一筆紀錄內重複出現同一群,只計一次。年份是文獻整理標籤,不一定等於研究觀測日期。技術情境則另行編碼;較晚發表的研究仍可能研究傳統搜尋,兩者不能混用。
本次研究參照 Donthu 等人(2021)對文獻計量與科學知識圖譜的區分,將資料組成、共現計算與關係解讀分別呈現。共現分析以同一研究紀錄同時包含兩個構念群為單位,並以 Jaccard 係數調整兩群規模差異。共現反映研究共同處理哪些問題,不表示兩者存在因果關係,也不表示影響程度。主題演進圖則以固定寬度的帶狀連結呈現語意延續與分化;因缺少同一群文獻在各時期遷移的完整資訊,不將帶寬偽裝為流量、效果量或文獻轉移數。
關係判讀回到研究設計,區分直接或條件關係、正式中介、正式交互作用、一般關聯及群組差異。原始圖中的虛線可能表示調節,也可能表示不顯著關係,不能單憑線型決定。主要論點優先以可取得的原始論文、作者摘要或出版資料交叉查證;未能取得完整報告的項目保留限制,不補寫被截斷的係數。
三、描述性結果:持續出現的是構念群,而非固定權重
七個構念群均出現在三個紀錄年份區間。以 40 筆主分析紀錄計,排序、介面與引用呈現出現於 26 筆,查詢、任務與決策條件出現於 24 筆,內容特徵與證據品質出現於 21 筆。這些次數說明研究關注範圍,不能據以排列 Google 的演算法權重。
表 3
核心構念群在不同紀錄年份區間的覆蓋筆數
| 構念群 | 2007–2022(N = 16) | 2023–2024(N = 5) | 2025–2026(N = 19) | 全部(N = 40) |
|---|---|---|---|---|
| 查詢、任務與決策條件 | 9 | 2 | 13 | 24 |
| 來源身分與可信基礎 | 6 | 1 | 5 | 12 |
| 內容特徵與證據品質 | 6 | 1 | 14 | 21 |
| 排序、介面與引用呈現 | 12 | 4 | 10 | 26 |
| 信任與主觀評估 | 4 | 3 | 10 | 17 |
| 使用者先備條件 | 9 | 2 | 5 | 16 |
| 平台、語言與觀測情境 | 3 | 3 | 11 | 17 |
註。 同一筆紀錄可涵蓋多個構念群,因此各欄不可相加為 N。數字表示出現該群的紀錄數,並非正向或顯著效果的研究數;年份沿用紀錄標示。
圖 1
核心構念群的研究共現網絡
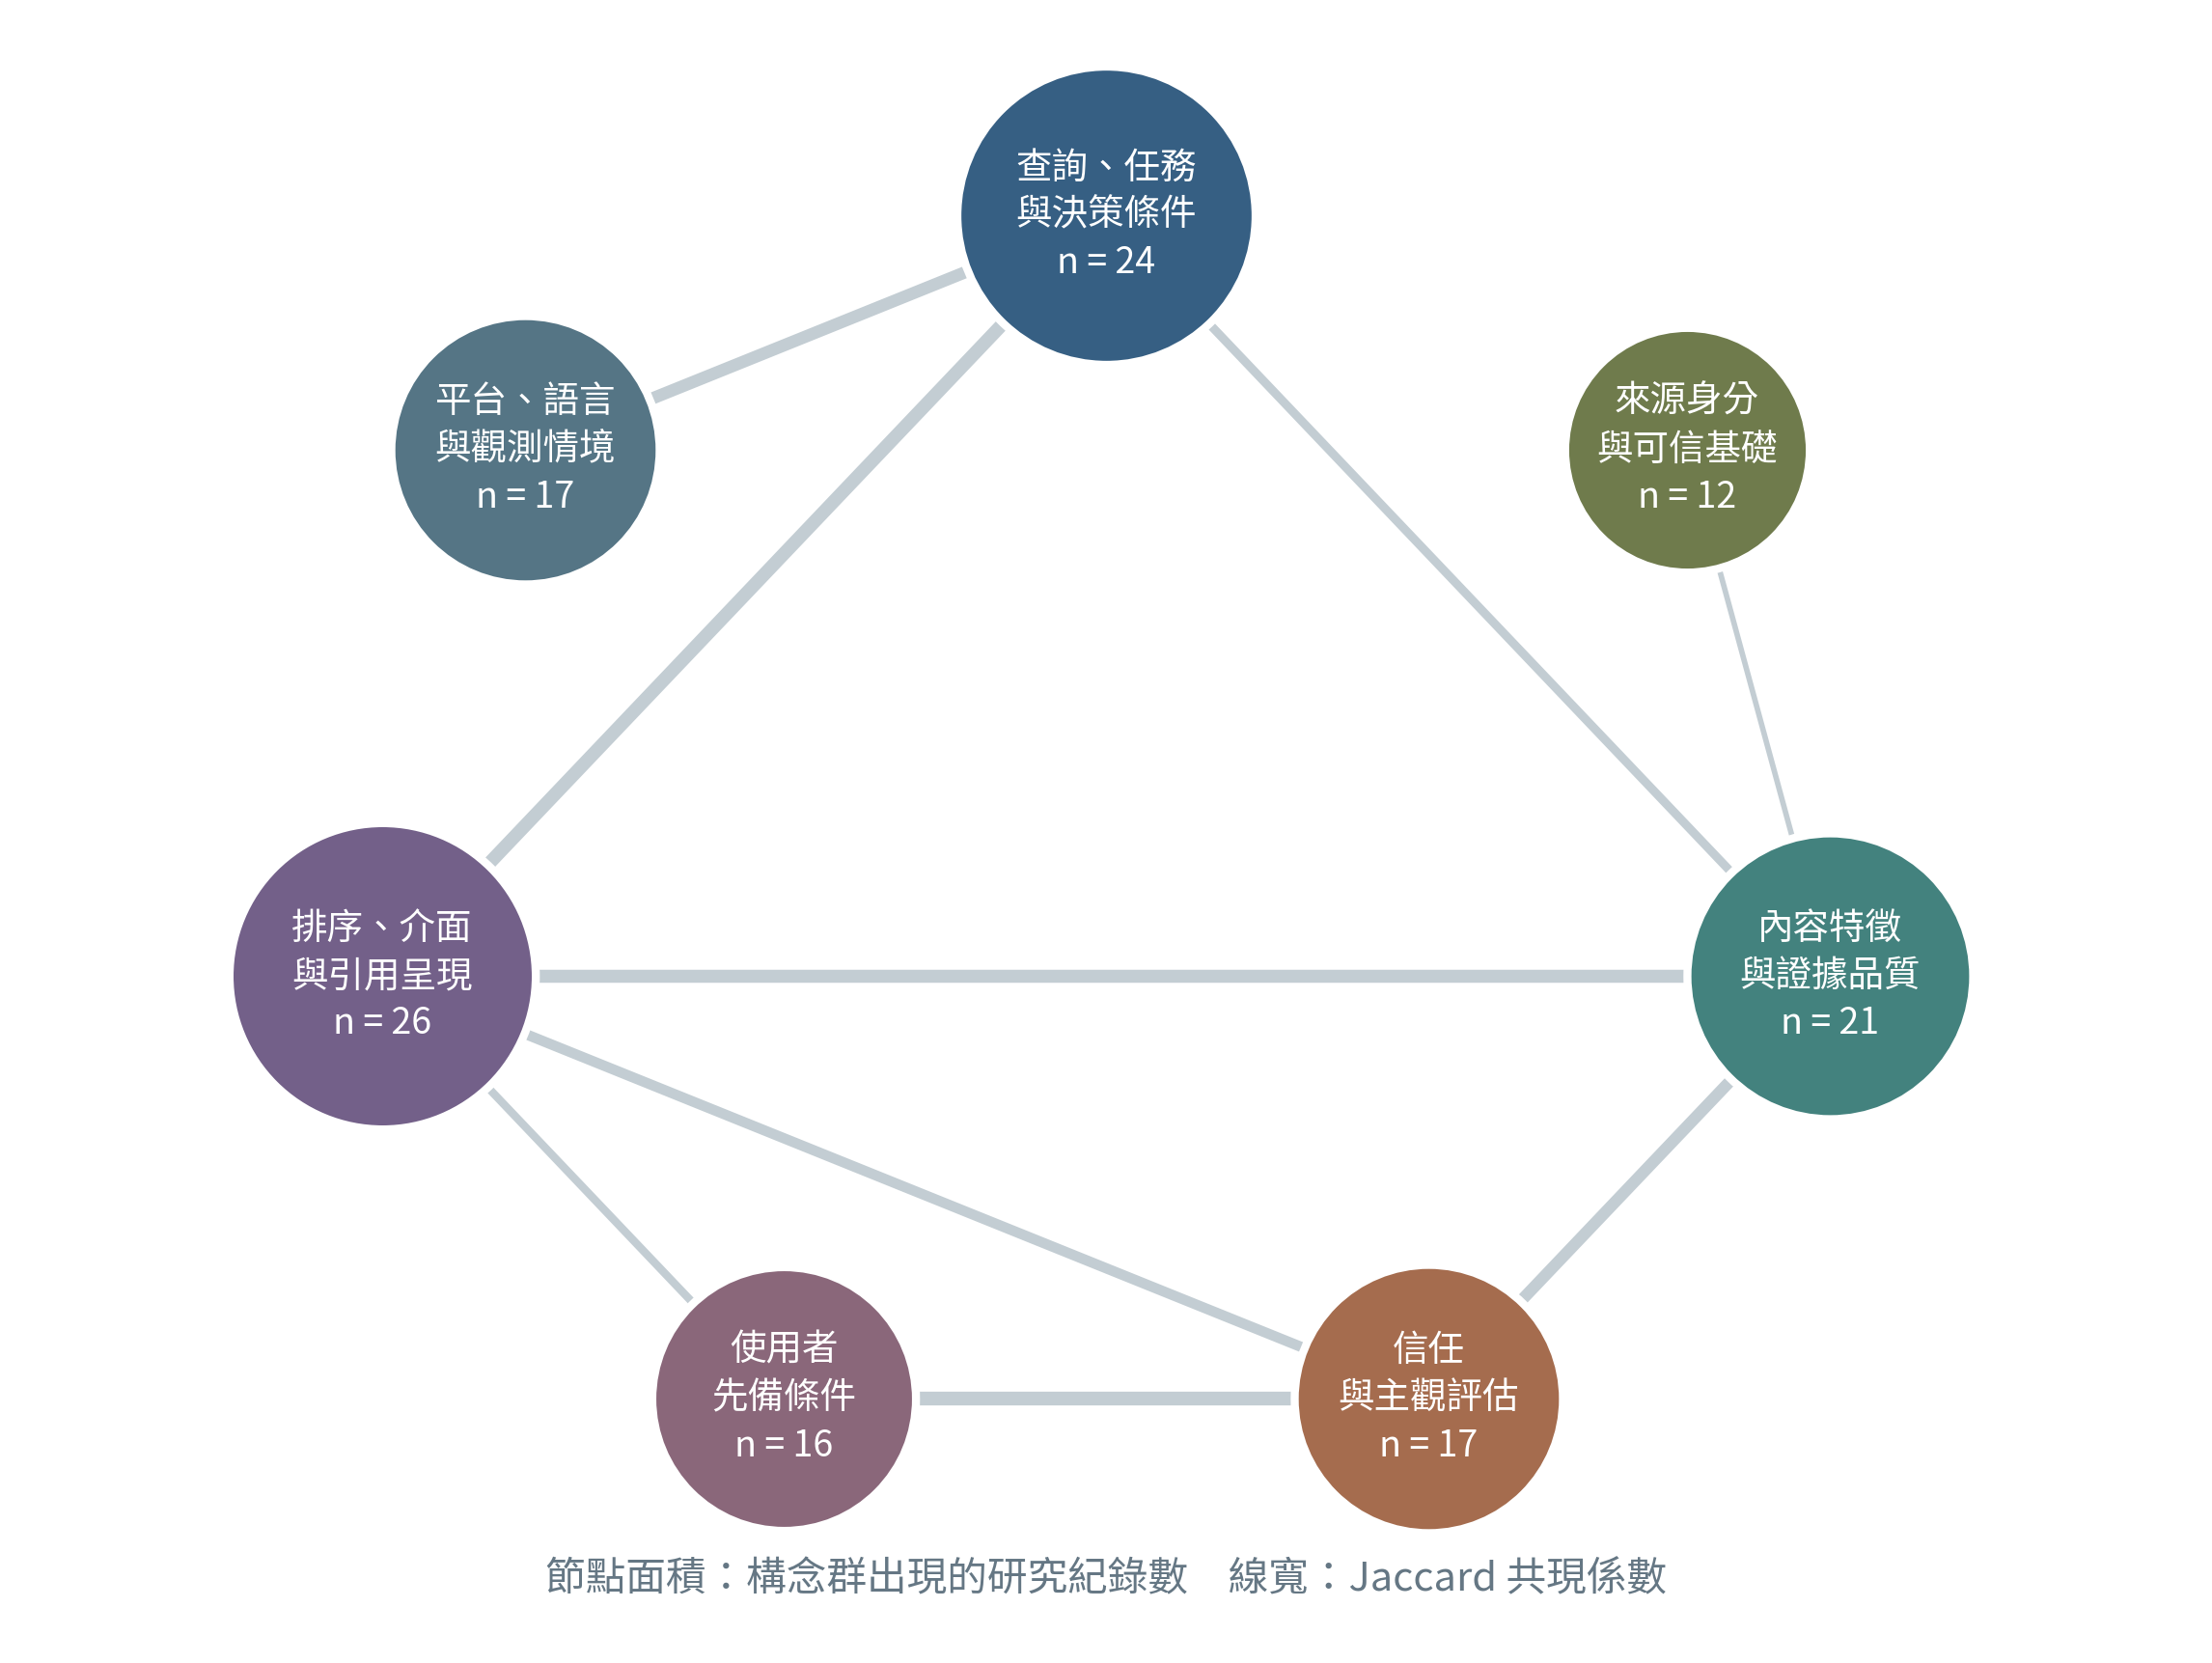
註。 N = 40。節點面積表示涵蓋該構念群的研究紀錄數;線寬依 Jaccard 共現係數,僅顯示係數 ≥ .30 的連線。單筆紀錄內重複出現僅計一次。共現不代表顯著效果、重要程度或因果路徑;構念群為人工語意編碼,非演算法分群。
共現網絡中,查詢與呈現同時出現於 15 筆紀錄,內容與呈現出現於 14 筆,查詢與內容出現於 12 筆。這個結構顯示,內容條件經常與任務和呈現一起被研究;因此,脫離任務與介面的單一內容配方,難以完整表達這批文獻的問題結構。
圖 2
不同紀錄年份區間的構念群覆蓋率
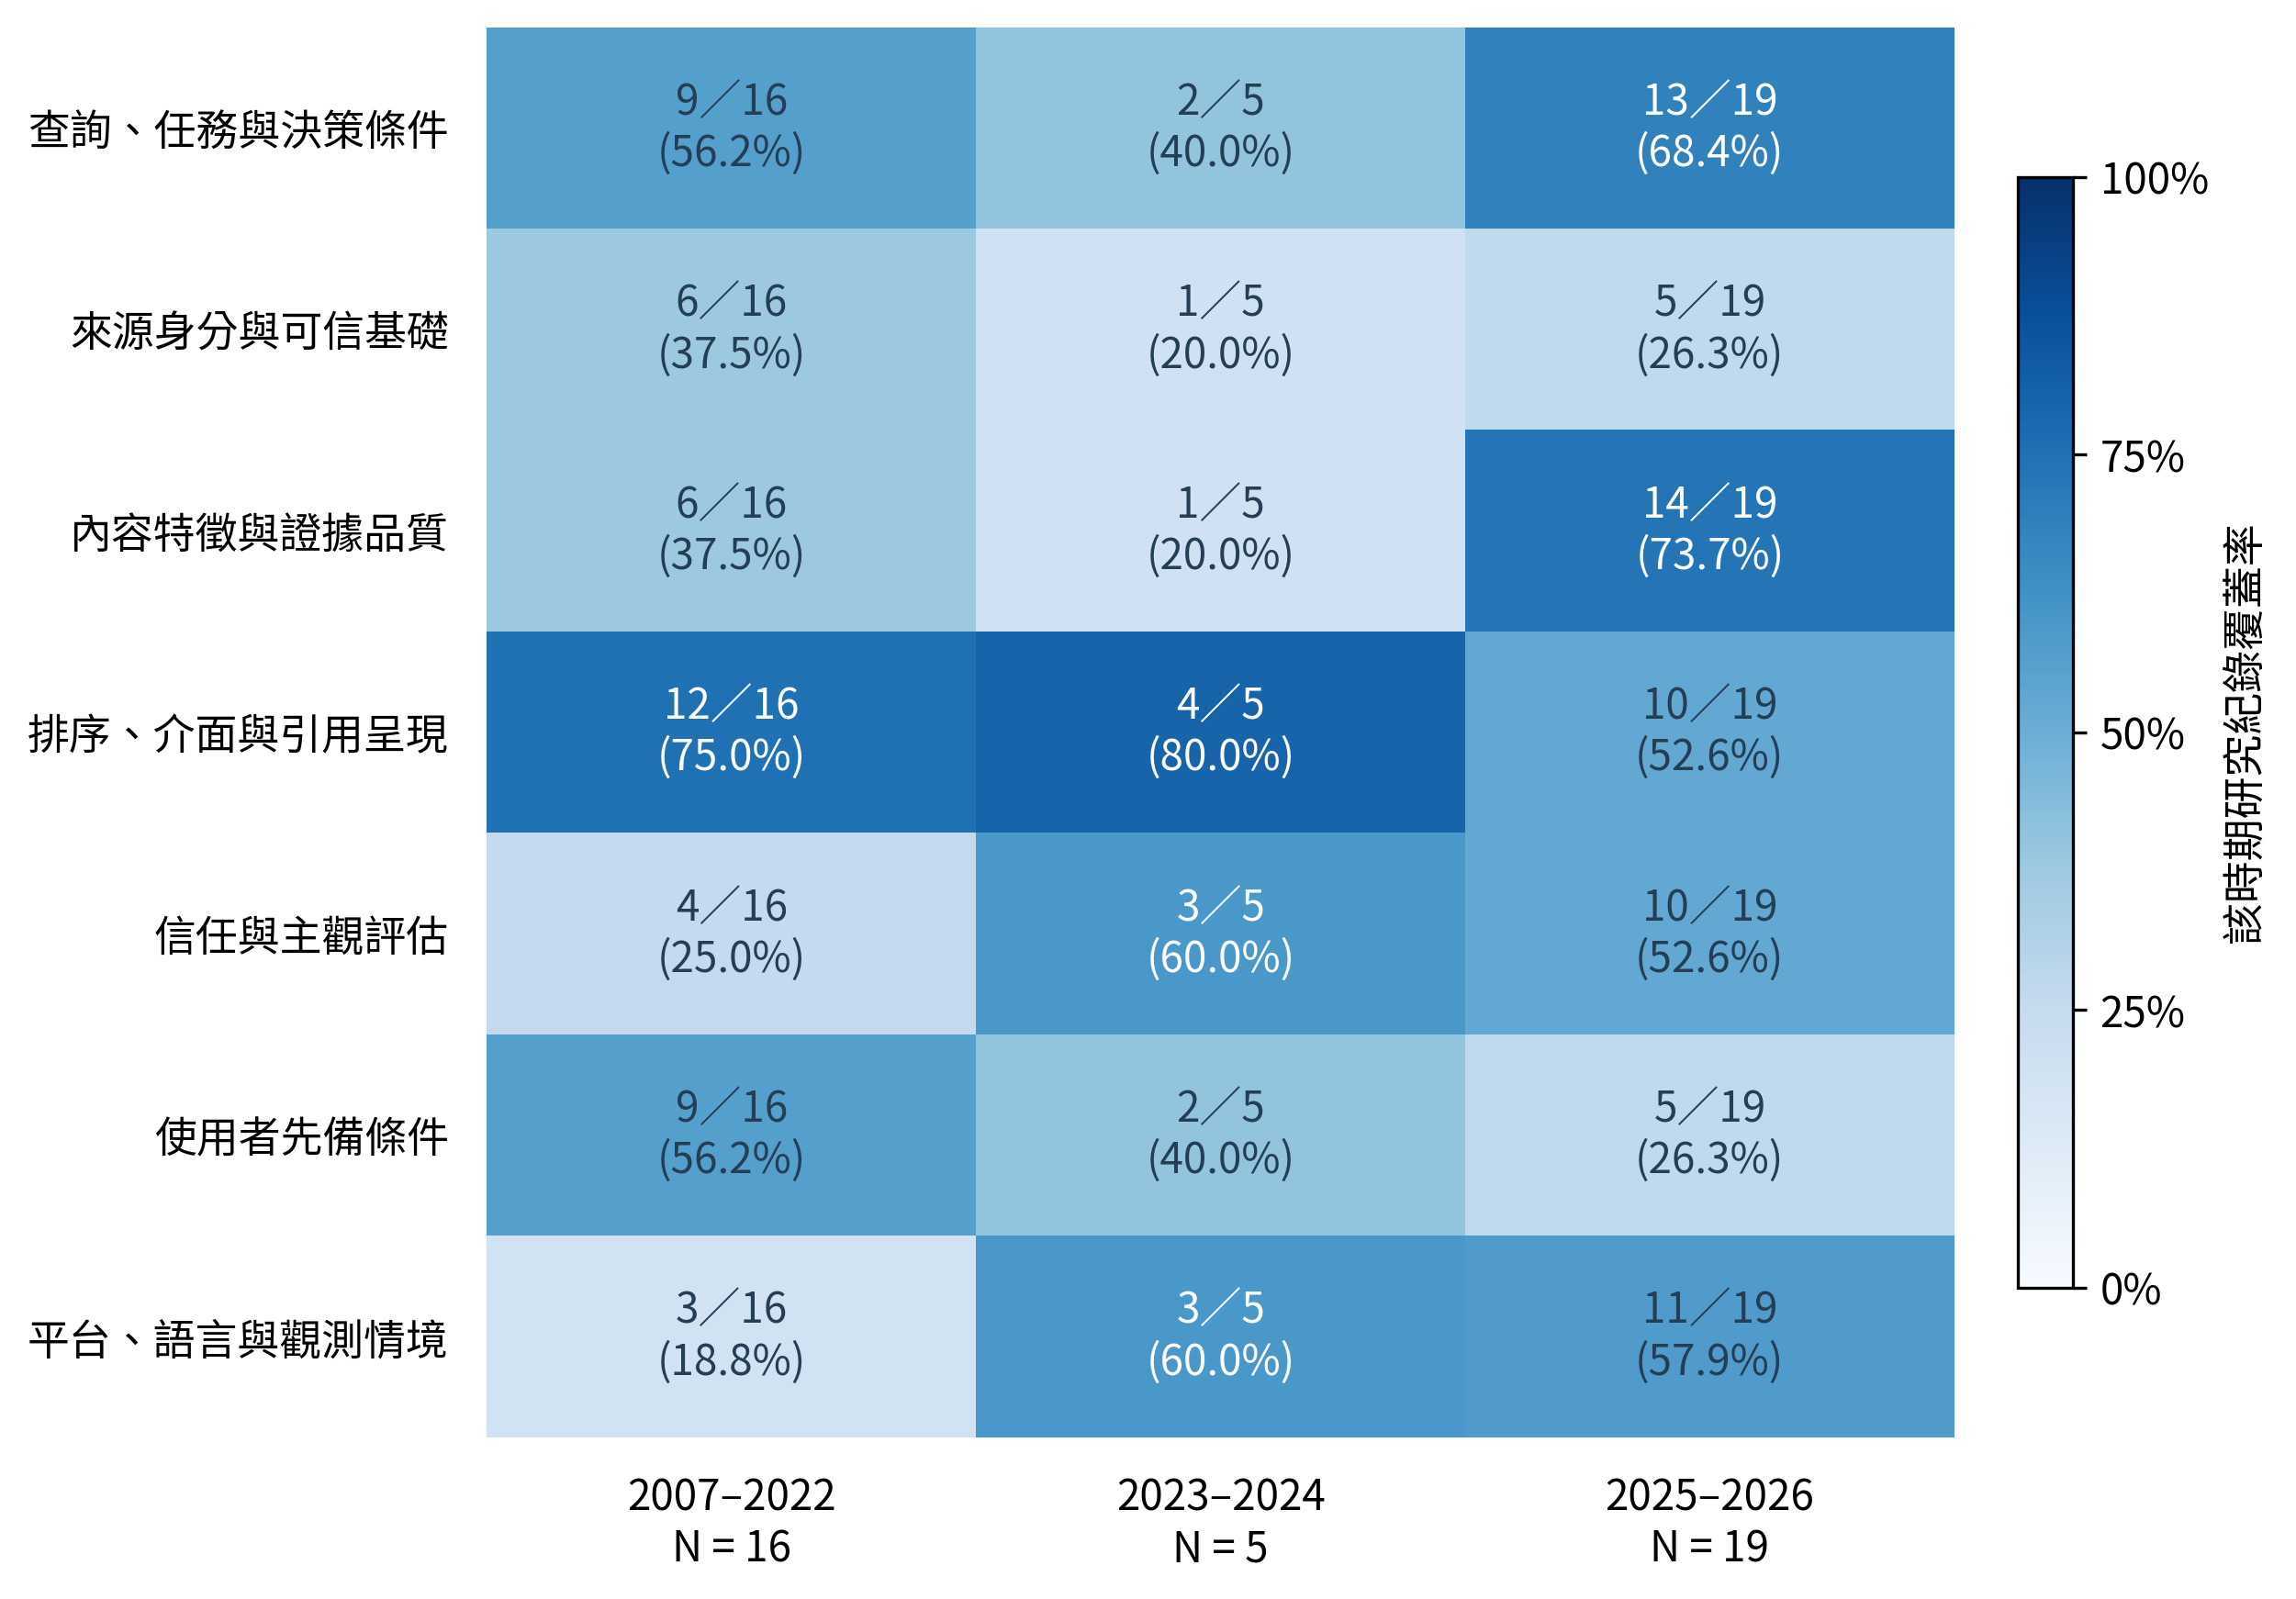
註。 年份依原始紀錄標示;N 分別為 16、5、19。各格為涵蓋該群的紀錄數/當期紀錄總數,與百分比。構念群可複選;覆蓋率不是效果量或顯著研究占比。中間區間樣本較少;上位群的持續出現不代表每個下位構念均持續獲驗證。
較新的紀錄中,內容與證據、平台與觀測情境的覆蓋率分別為 73.7% 與 57.9%。這可以描述本資料集的研究焦點,卻不足以宣稱它們對成效的作用正在增強。尤其 2023–2024 年僅有 5 筆主分析紀錄;其中「內容」也可能指答案立場,而非事實正確性。上位群跨期存在,不代表每一項下位變項都連續接受檢驗。另分別排除共享資料的 B08、年份標示有差異的 A05,及同時排除兩者後,七個上位群仍均涵蓋三個區間;這項敏感度檢查只支持構念覆蓋的描述,未解決所有研究相依性。
主分析共 280 條關係陳述,其中 150 條帶有方向標示、61 條為混合或條件關係、40 條為不顯著或未見差異、29 條為未明確定向或描述性關係。這些是整理圖中的陳述數,並非相互獨立的統計假設;本次研究不以顯著次數投票判定因素有效。
四、跨期關係分析:哪些機制延續,又在哪裡分化?
圖 3
從排名搜尋到 AIO 的構念延續與研究焦點分化
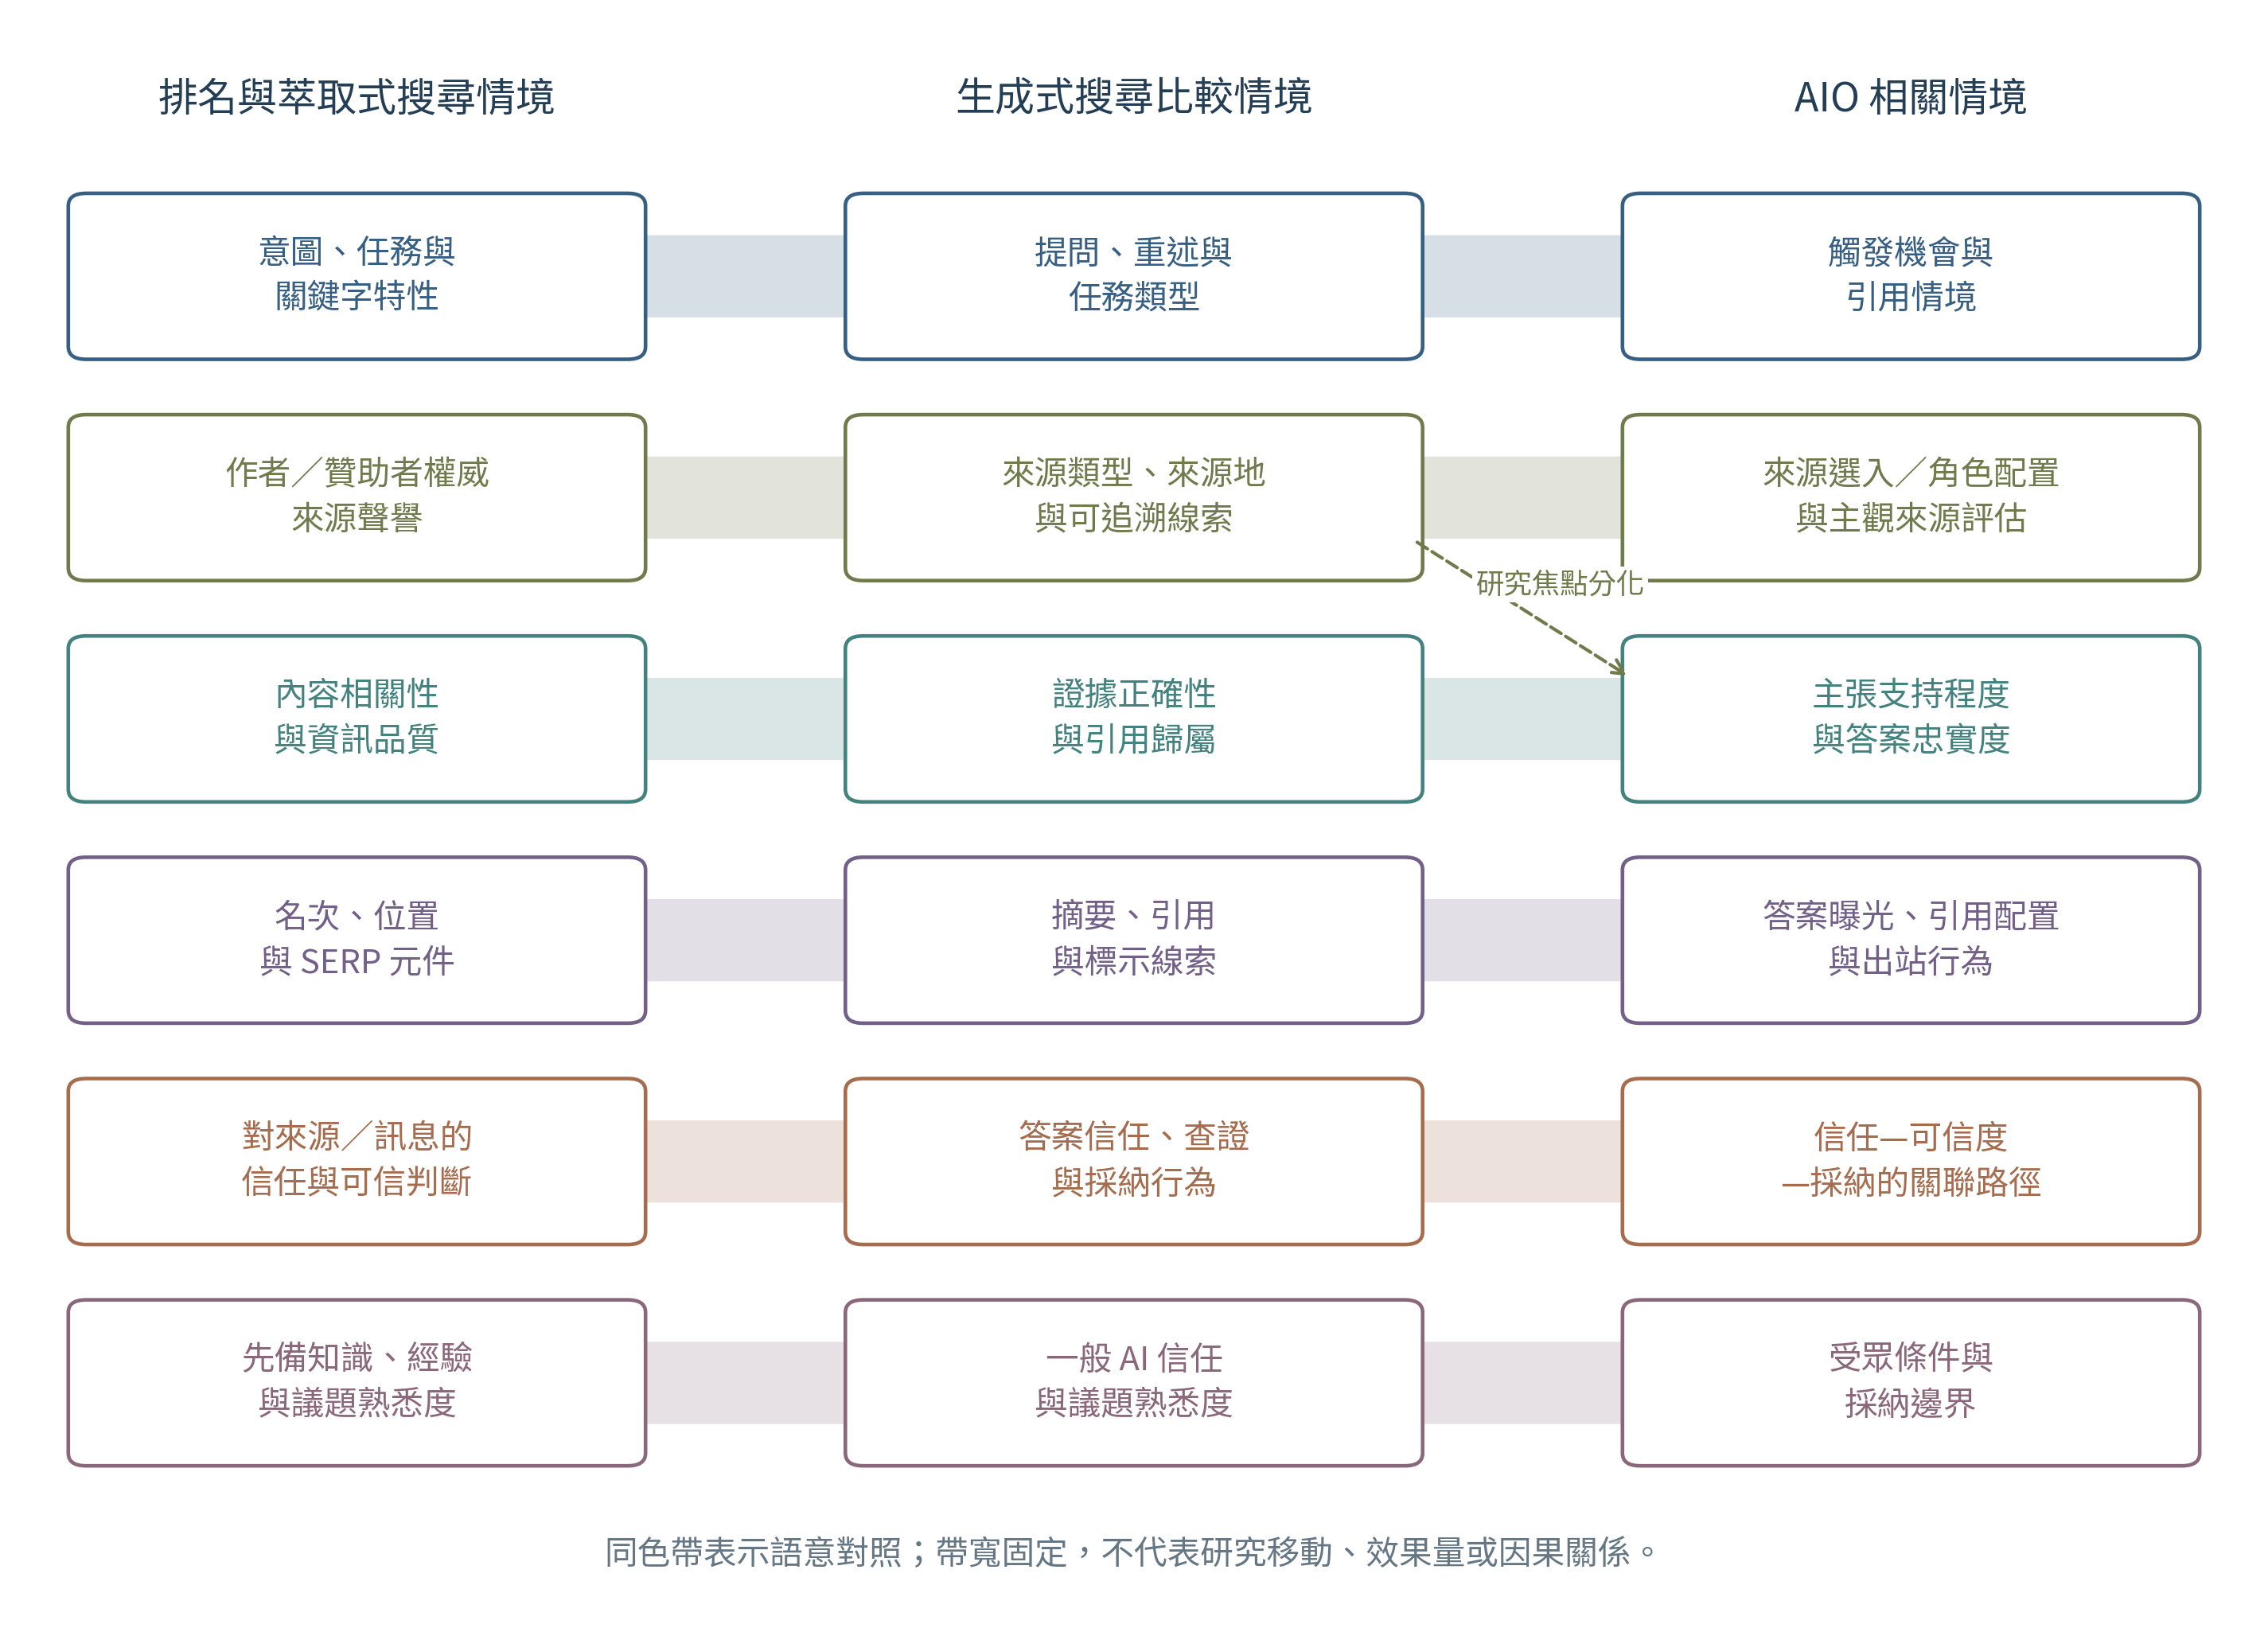
註。 本圖為依個別研究內容整理的定性主題演進示意。三欄為技術/研究情境,並非互斥的出版年代。固定寬度色帶表示語意對照,沒有數量權重;不表示文獻遷移數、效果量或因果鏈。來源角色與主張支持的分化是本次研究的整合解讀,不主張同一變項沿箭頭演化。
4.1 查詢與任務:從點擊條件,擴展到答案出現與來源配置
查詢與任務是跨期最穩定的問題之一,但它不是永遠處於相同位置。在傳統 SEO 研究中,Nagpal 與 Petersen(2021;G01)分析零售、餐飲教育及急迫醫療服務三類網站的 1,791 個查詢,指出搜尋意圖會改變內容相關性、線上權威與自然搜尋點擊之間的關係。這裡的意圖具有條件角色:同樣的內容或權威線索,對不同任務未必產生相同的點擊關聯。
在 AIO 量測研究中,問題往上游移動。Xu 等人(2026;A02)的資料顯示,問句型查詢的 AIO 出現比例為 64.7%,非問句型為 9.5%。這項差異說明查詢形式與答案出現有關,並未直接證明把標題改成問句就會提高某個頁面的引用機率。前者的結果變項是「是否出現 AIO」,後者則是「來源是否被選用」,分析單位不同。
Cheng(2026;A01)的電商比較進一步把任務連到來源角色:官方、評測與交易通路在 AIO 與自然搜尋結果中的配置有所不同。這顯示,商品相關內容的價值不能只用同一種查詢或同一種來源角色判斷;資訊需求、比較需求與交易需求需要分開看。
因此,跨期可延續的結論是「任務需求限定了內容與來源發揮作用的情境」,而非「某一種句型普遍提高引用」。目前可以直接採用的做法,是以真實決策問題拆分內容用途:解釋規格、提供比較依據、交代適用條件,以及支援購買決策。不同任務是否觸發 AIO、又偏向何種來源,應依其直接證據判讀。
4.2 來源權威:從人的可信線索,分化為來源選入與證據支持
早期研究常把來源權威視為人的判斷線索。Westerwick(2013;F02)研究贊助者身分、設計與 Google 高排名文字線索,所解釋的是感知贊助者可信度與訊息可信度。Sbaffi 與 Rowley(2017;C07)對網路健康資訊的回顧,也將作者、來源、設計與使用者的可信判斷放在同一個研究脈絡。這些研究支持來源身分具有解釋價值,但其結果首先關於人如何評估資訊。
生成式搜尋加入了一個不同的問題:系統究竟選用哪些來源。A01 對來源角色配置的分析,與 A02 對來源品質及主張忠實度的量測,都不能直接化約為「人覺得這個品牌可信」。同樣地,A02 指出來源品質與答案主張的忠實度大致獨立,意味著較好的來源品質指標,不能代替逐項檢查答案是否受到引用材料支持。
本次研究因此將原本容易合併的「權威」拆成三層:可識別的來源身分、系統實際選入的來源,以及來源對具體主張的支持程度。三者可能相關,卻沒有充分證據把它們接成一條必然成功的鏈。品牌聲譽、作者專業與可追溯資料各有用途,不能相互代替。
對實務的含義是,來源建設與證據建設應有各自的工作內容。前者交代作者、組織、經驗與資訊責任;後者交代數據來源、適用條件、更新日期及可查證依據。這有助於建立可信且可核對的資訊,但本資料集尚不足以估計每項作法能增加多少 Google AIO 引用。
4.3 內容品質:由「是否相關」走向「主張是否有證據,以及是否被忠實使用」
內容相關性是早期搜尋研究的重要構念;生成式搜尋使品質問題出現新的分工。網頁可以與問題高度相關,引用也可以確實存在,但生成答案仍可能沒有忠實呈現原文。因此,「找到相關頁面」「引用可用」「主張獲得支持」「答案沒有扭曲證據」,應視為相連但不同的評估項目。
在跨領域整理中,健康資訊研究的可信判斷、新聞政治研究的來源地與引用歸屬,以及 AIO 稽核的主張忠實度,都涉及資訊與證據的關係。然而,醫療的事實正確性、政治摘要的立場與來源多樣性、商業資訊的決策適用性,不宜被壓成一個毫無差別的「高品質內容」分數。它們可以在上位層對話,下位測量仍須保留。
技術與模擬補充研究進一步討論語意吻合、內容結構、證據與引用吸收之間的關係。這些研究提供值得測試的機制,但受測引擎、檢索器與評估規則不同,不能據此宣稱某種條列方式、篇幅或引文密度已被證實適用於 Google AIO。
目前較有根據的內容規劃,是讓重要主張具有足夠脈絡與可核對依據:定義清楚、條件完整、數據有來源、比較有基準。這項建議來自跨研究對相關性與證據品質的共同重視;至於它能否提高特定查詢的引用率,仍應列為企業實際 AIO 情境中的驗證問題。
4.4 排序與介面:曝光分配機制延續,成效路徑增加分岔
排序與呈現出現於 26 筆主分析紀錄,是本資料集中覆蓋最廣的構念群。早期研究主要處理名次、注意力、點擊與可信判斷;摘要與知識面板研究則把資訊取得移到結果頁,增加了「看過資訊但沒有點擊」的路徑。AIO 延續這項變化,同時加入答案本身的曝光與引用配置。
A02 發現,AIO 引用來源與當時自然搜尋第一頁只有部分重疊;以每個 AIO 的來源網域比例取平均,29.8% 來自當時第一頁之外。這不能解讀為「29.8% 的所有網頁」,也不能解讀為排名已經不重要;它只表明第一頁排名不是 AIO 來源清單的完整替代指標。
Agarwal 與 Sen(2026;A07)的隨機田野實驗,則把結果從來源清單推進到人的出站行為。其公開研究摘要指出,在會出現 AIO 的搜尋情境中,AIO 使自然搜尋出站點擊減少 39.8%。這項證據涉及介面的點擊效果,不等於被引用網站的內容品質下降,也不意味所有產業都會有相同幅度。
因此,目前的成效判讀至少有三個不同環節:內容是否成為來源、答案如何使用該內容,以及使用者是否需要離開搜尋頁。它們不是已被驗證的單一路徑模型,也不一定同步變動。被引用具有可見度價值,是否帶來網站流量與商業成果,仍需另行判斷。
4.5 信任與可信度:中介機制持續可見,但不能從箭頭推定
主觀評估是跨期可見的解釋機制。F02 報告 Google 高排名文字線索透過感知贊助者可信度,間接關聯到訊息可信度;其 bootstrap 間接效果為 .102,95% BCa 信賴區間 [.004, .183],總效果未達顯著。這是一項有正式間接效果檢定的例子,但操弄的是文字線索,不是真實結果頁的排名移動,研究也有對照資料設計限制。
較新的 AIO 研究(Casermeiro-Corpas 等人,2027;原始紀錄 A05 標示 2026),以西班牙問卷 510 人及眼動觀察 20 人討論信任與可信度。其模型將清晰與脈絡、支持來源可取得性,連到信任、可信度與遵循建議;但問卷為橫斷面自陳資料,不能僅因存在連續箭頭,就宣稱已證實「清晰度造成信任,再造成採納」的因果串聯中介。
兩者共同指出的是,呈現或來源線索與人的反應之間,主觀評估值得被納入解釋。共同見解並不是所有文獻都具有相同順序。C07 所回顧的研究對信任與可信度的定義及位置並不一致;因此,本次研究保留其下位差異,不強行合成一個跨期固定的中介模型。這些人類判斷機制也不能被轉述為 Google 演算法具有同名的「信任中介」。Li 與 Aral(2025;B04)另外發現,引用連結即使不正確,仍可能增加人的信任。這進一步說明「看起來有根據」與「確實有根據」需要分開,且不能僅憑信任與點擊相連,就補上未經正式檢定的中介效果。
4.6 調節條件:同一內容,對不同任務與受眾可能產生不同反應
調節回答的是「在什麼條件下,某項關係會改變」。G01 的搜尋意圖交互作用,是任務條件的實例;使用者知識、經驗與熟悉度,則構成另一組跨期邊界。但某變項曾被研究,不代表每一次都存在顯著調節效果。
Xu 等人(2025;B05)在 2,004 人的模擬健康搜尋實驗中,針對特定利益取向摘要條件,報告議題熟悉度與一般 AI 信任的交互作用:前者 B = −.19、p = .003,後者 B = .25、p = .001。這支持摘要對健康態度的影響依既有條件而異,適用範圍是該操弄、議題及結果;並非所有摘要立場、所有結果均得到相同證據。
這裡還有一個重要的角色差異:「使用前對 AI 的一般信任」可以是調節條件,「看過答案後對該答案的信任」則可能位於反應路徑中。兩者若只合併成「信任」,便會把調節與中介混淆。
目前可用的應用是,內容應考慮受眾的理解門檻與決策經驗;新手可能需要定義與脈絡,熟悉者則可能更在意可核對細節與例外條件。這屬於人類理解與採納的規劃依據,不能進一步聲稱使用者熟悉度會改變 Google 選用某頁面的機率。
圖 4
正式中介、連續關聯路徑與調節條件的區別
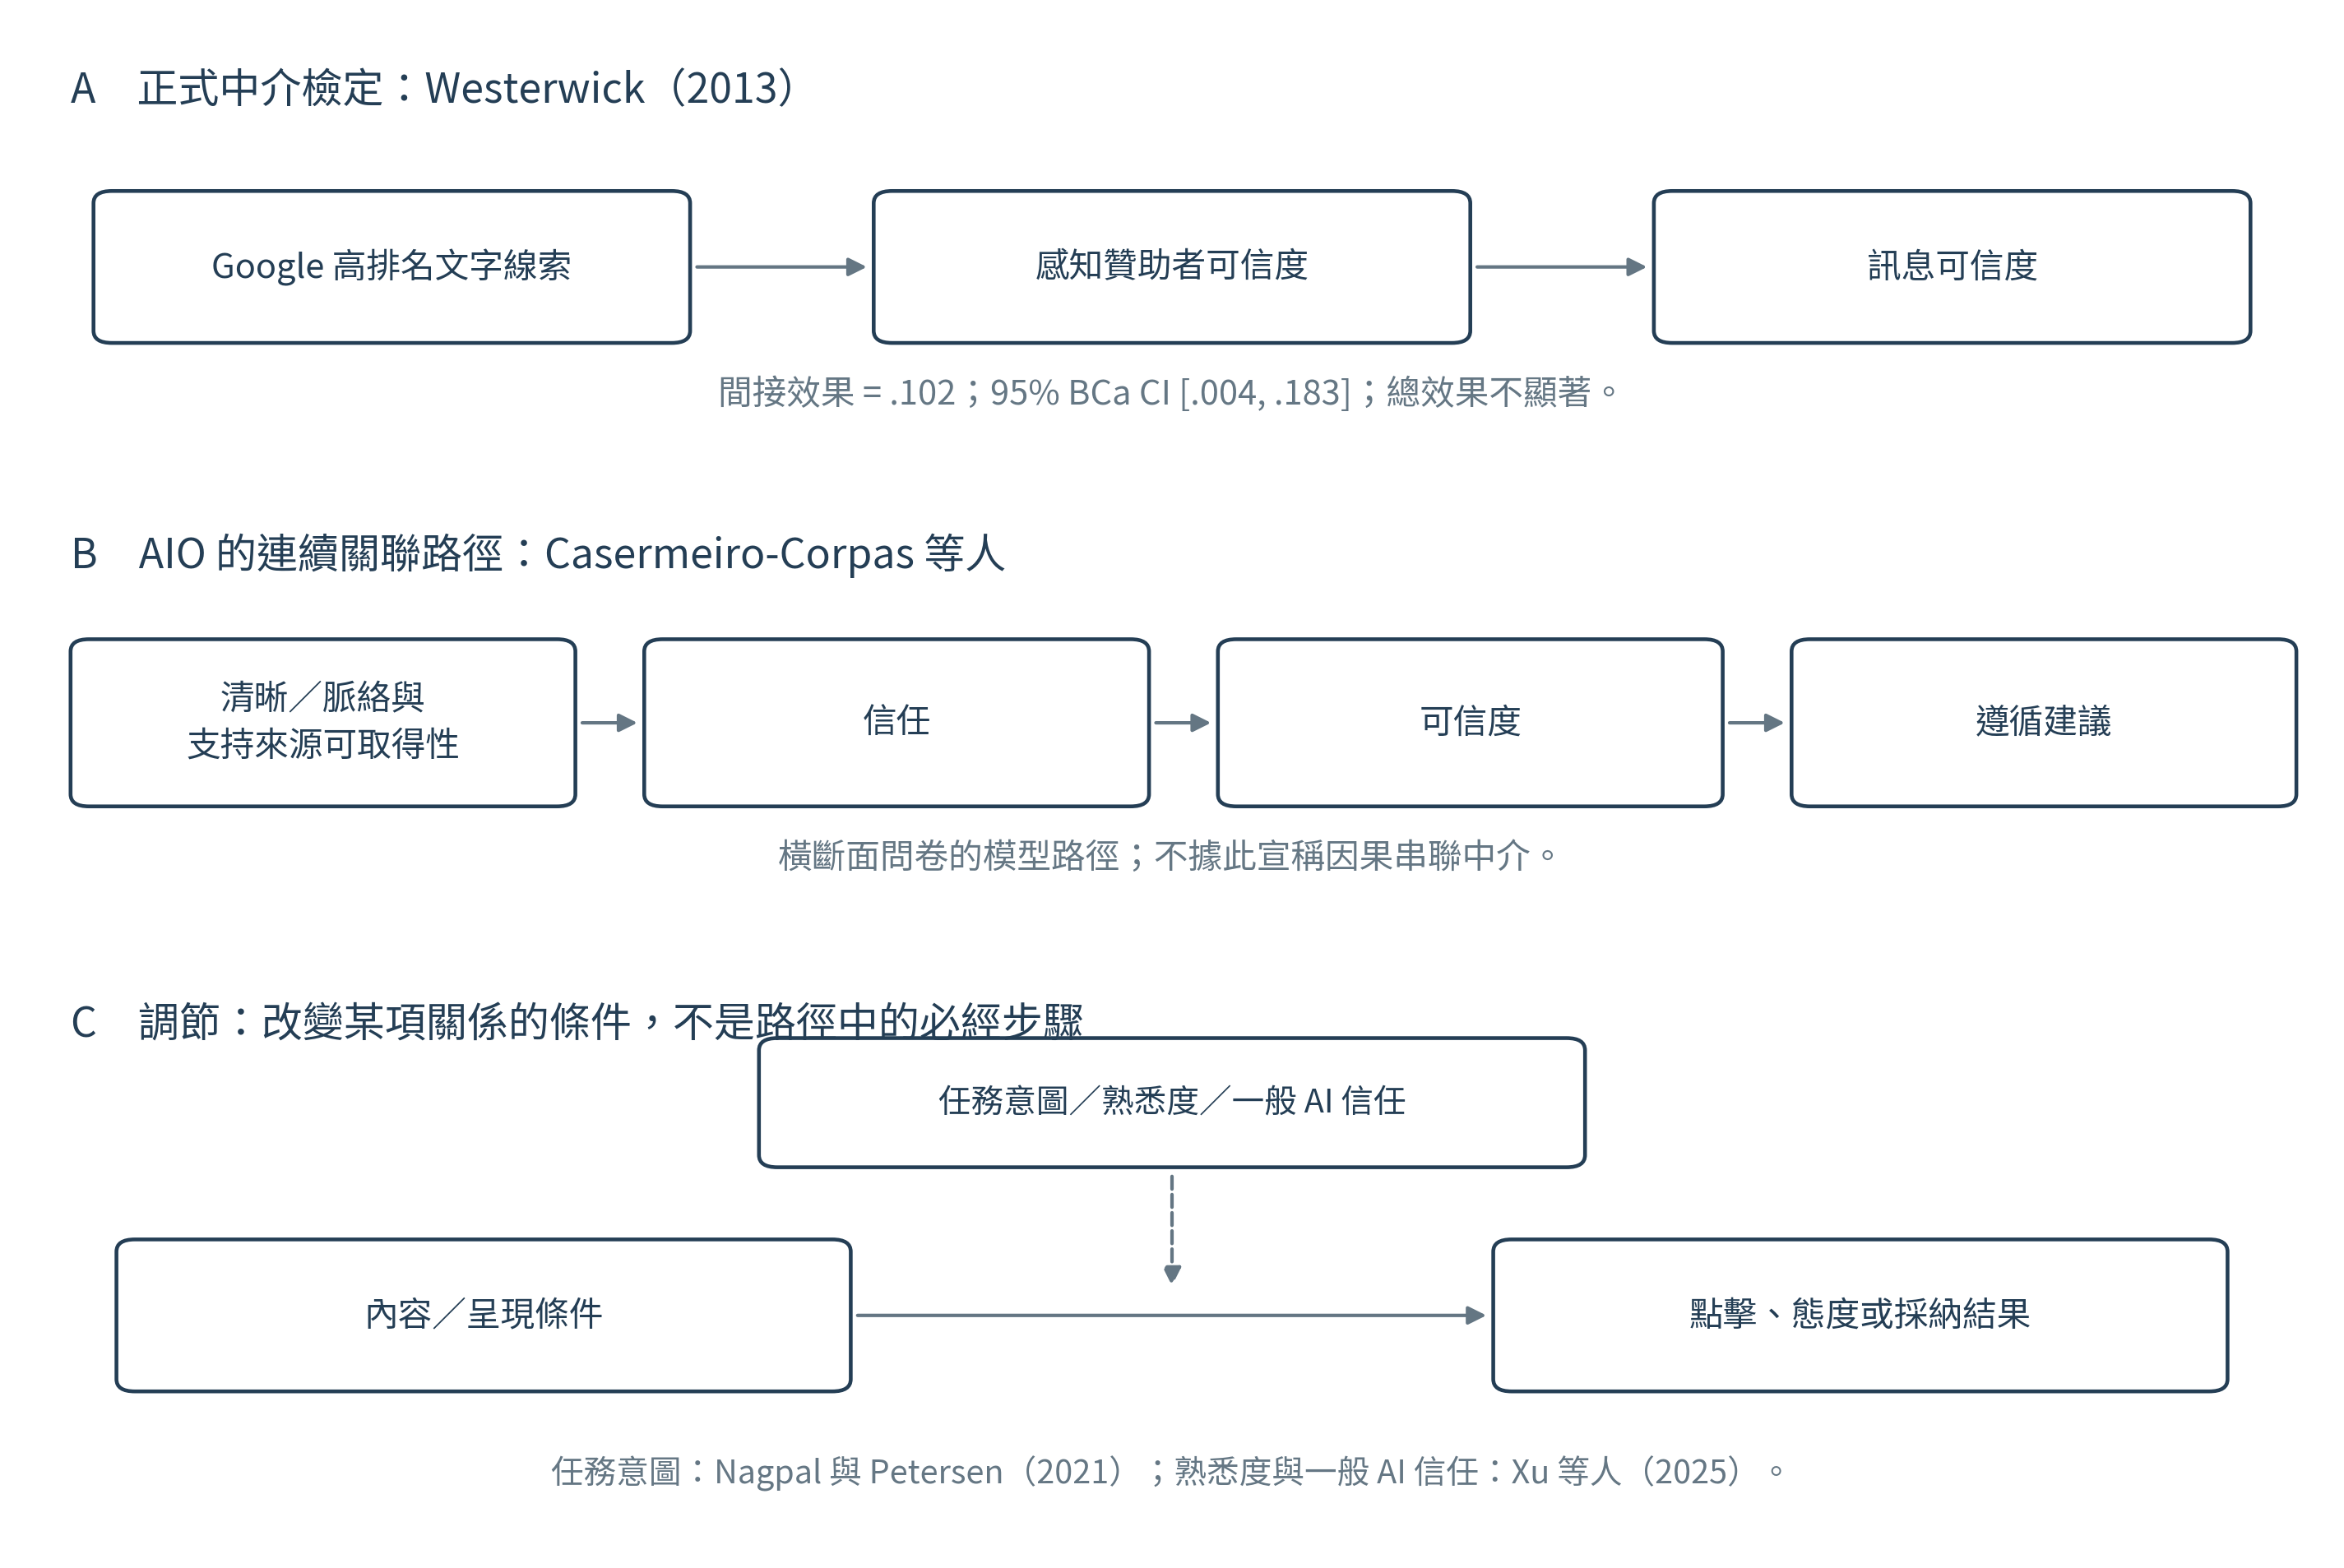
註。 A:Westerwick(2013),間接效果 .102,95% BCa CI [.004, .183];操弄為高排名文字線索,非真實排名移動。B:Casermeiro-Corpas 等人(2027;紀錄 A05 標示 2026),為橫斷面模型關聯,不據此宣稱因果串聯中介。C:整合 Nagpal 與 Petersen(2021)及 Xu 等人(2025)的條件概念,不表示三者在同一模型中接受檢定;結果為人的點擊、態度或採納,非 Google 的來源選用。
4.7 平台、語言與時間:共同的適用邊界,不必然是正式調節
平台、語言與時間在較新紀錄中更常被處理。B07 與 B08 的 Copilot 多語言研究顯示,語言與來源地、來源類型等配置差異有關;兩篇使用同一組資料,不能視為兩次獨立重複驗證,也不能直接等同 Google AIO 的語言效果。
AIO 的裝置與時間稽核則提醒,引用集合及介面具有變動性。重複查詢的差異可以由多項條件造成,僅觀察到變動,並不足以指定某次演算法更新為原因。群組之間不同,也不自動構成統計上的調節;正式調節需要對關係本身的變化提出檢定。
因此,跨期共同結論是:研究發現需要攜帶其平台、語言、期間與觀測條件。將英文查詢的字數門檻、單一地區的來源比例或模擬引擎的格式效果,直接搬到臺灣繁體中文 AIO,會超出既有證據。
五、整合解讀與目前的操作意涵
跨期整合顯示,持續出現的是一套問題結構:任務需求限定資訊用途,來源與內容提供判斷材料,呈現方式分配曝光,而主觀評估及先備條件影響人的反應。生成式搜尋的改變,在於這個結構增加了機器選取與答案組合的層次,使過去容易被放在一起的「權威」「品質」「成效」必須進一步拆開。
這些關係不是可以直接加總的統一模型。傳統搜尋的點擊研究、AIO 的來源稽核與人的採納研究,解釋的是不同結果;目前也缺少將所有環節放進同一項縱貫或實驗設計的證據。本次研究的貢獻是辨識可銜接的構念及其界線,為實務提供較精確的判斷單位。
表 4
跨研究發現與目前操作的連結
| 跨研究可支持的判斷 | 目前可採取的安排 | 證據適用界線 |
|---|---|---|
| 任務需求反覆影響內容、來源與反應的解釋 | 按解釋、比較、決策等實際需求規劃內容,保留適用條件 | 問句出現率不等於頁面引用率 |
| 來源身分與主張支持是不同層次 | 分別交代作者/組織責任,以及主張的數據與可查證依據 | 品牌權威不能代替忠實度檢查 |
| 相關性、證據品質與答案忠實度需要分開 | 讓重要主張有定義、比較基準、限制與原始來源 | 尚無通用的格式或篇幅增益估計 |
| 介面改變資訊曝光與出站路徑 | 分開判讀被選為來源、答案使用方式與網站成果 | 曝光、引用、點擊與營收不能互相替代 |
| 熟悉度與既有信任限定人的反應 | 為新手與熟悉受眾提供不同深度的脈絡與核對材料 | 屬人類反應證據,非機器引用因子的直接驗證 |
| 平台、語言與觀測條件限定外推 | 將直接 AIO 證據與其他引擎、模擬證據分層使用 | 在地效果與更新後效果仍須實測 |
註。 本表為本次研究的整合解讀;操作安排不等於均已通過直接 Google AIO 實驗,其界線列於第三欄。
少量出現、只有特定研究支持的構念,保留在關係清冊中,未列為共同主軸。某項變項未在後期文獻出現,也不能推論它已經失效;可能只是後續研究改問別的問題。真正的「消退」需要可比較的重複觀測,而非以未被測量代替效果消失。
六、研究限制
首先,本次研究以既有整理資料為基礎,並非完整的系統性資料庫檢索;文獻選擇與原始摘錄可能影響構念分布。部分關係標籤被截斷,未能完整查證的細節不作為精確係數的依據。
其次,研究紀錄並不完全獨立。回顧文獻可能包含主分析中的個別研究,B07 與 B08 也共享資料。覆蓋率與共現數是紀錄層的描述,不能當作獨立樣本的效果量統合。不同研究使用的結果包括點擊、信任、態度、來源選入與忠實度,不能直接合併估計。
第三,跨期覆蓋描述的是上位構念的延續;不是同一測量工具、同一效果方向或同一中介路徑的連續重複。三個區間的紀錄數不均,特別是中間區間僅有 5 筆,無法據此進行穩健的研究趨勢推論。主題演進圖是語意關係的整理,不能取代有完整引文資料的共被引分析或正式文獻遷移分析。
第四,本次研究由單一分析者進行語意編碼,尚未完成獨立複編與編碼者一致性檢定。上位群的廣度會影響持續性判讀,因此同時提供原始標籤、下位構念與關係清冊,供後續查核與修訂。
第五,部分證據來自模擬結果頁、其他生成式引擎、單一地區或橫斷面問卷。正式中介、交互作用及一般群組差異的證據強度不同;本次研究不將其視為同一類因果證據。對目前操作的意涵屬有界線的研究整合,並非所有作法都已有 Google AIO 隨機實驗支持。
最後,紀錄年份與正式出版年可能不同。例如 A05 原始紀錄標為 2026,出版資料列於 2027 年卷期;本次研究為維持資料版本可重現性,時間統計沿用原始紀錄年,參考文獻則註明正式卷期資訊。後續應以一致的時間基準更新,而非將兩者混作真實的技術演進日期。
七、結論
本次研究從跨期、跨領域的關係資料中,歸納出持續可見的七個構念群。其共同性不在於每個因素始終對 AIO 引用產生相同效果,而在於任務、來源、內容、呈現與人的判斷反覆構成資訊取用的解釋框架。生成式搜尋進一步使來源選入、主張支持與人的採納分化為不同的研究問題。
對目前的 AIO 規劃,較有根據的方向是:以任務限定內容用途,以可追溯來源支撐具體主張,並將機器選用、答案忠實度及人的反應分開處理。中介與調節提供了理解「為什麼」及「在什麼條件下」的依據;其證據必須跟隨原始設計,不能從一張箭頭圖擴張成通用的演算法機制。
參考文獻與查核說明
以下列出本文核心論點的主要原始來源。完整 57 筆紀錄的原始編號、標籤、關係與分析範圍另行保存;本文不宣稱每一筆紀錄均取得全文。出版資訊尚有差異者明列說明。
Agarwal, S., & Sen, A. (2026). The impact of Google AI Overviews on publisher traffic and user experience: Evidence from a field experiment [工作論文;本文效果數值依研究機構公開摘要]. Toulouse School of Economics
Casermeiro-Corpas, Y., Rejón-Guardia, F., Vallespín, M., & Molinillo, S. (2027). From search results to generative answers: A mixed-methods study of credibility assessment and trust formation in AI Overviews. Information Processing & Management, 64(2), Article 105211. https://doi.org/10.1016/j.ipm.2026.105211 [原始紀錄 A05 標示為 2026;正式卷期為 2027。本文以出版摘要及原始整理紀錄交叉判讀。]
Cheng, C.-Y. (2026). Citation governance in generative e-commerce discovery: When breadth looks diverse but intensity concentrates. Electronic Markets, 36, Article 64. https://doi.org/10.1007/s12525-026-00920-0
Donthu, N., Kumar, S., Mukherjee, D., Pandey, N., & Lim, W. M. (2021). How to conduct a bibliometric analysis: An overview and guidelines. Journal of Business Research, 133, 285–296. https://doi.org/10.1016/j.jbusres.2021.04.070
Li, H., & Aral, S. (2025). Human trust in AI search: A large-scale experiment. arXiv. https://arxiv.org/abs/2504.06435 [此列為資料索引;本文未據此額外宣稱正式中介效果。]
Nagpal, M., & Petersen, J. A. (2021). Keyword selection strategies in search engine optimization: How relevant is relevance? Journal of Retailing, 97(4), 746–763. https://doi.org/10.1016/j.jretai.2020.12.002
Sbaffi, L., & Rowley, J. (2017). Trust and credibility in web-based health information: A review and agenda for future research. Journal of Medical Internet Research, 19(6), e218. https://doi.org/10.2196/jmir.7579
Westerwick, A. (2013). Effects of sponsorship, web site design, and Google ranking on the credibility of online information. Journal of Computer-Mediated Communication, 18(2), 80–97. https://doi.org/10.1111/jcc4.12006
Xu, H., Iqbal, U., & Montgomery, J. M. (2026). Measuring Google AI Overviews: Activation, source quality, claim fidelity, and publisher impact. arXiv. https://arxiv.org/abs/2605.14021 [本次研究查閱 arXiv v2;另已刊於 IMC 2026,頁 529–546,DOI: 10.1145/3777912.3839818。]
Xu, Y., Dash, S., Kang, S., Liao, W., & Spiro, E. S. (2025). AI summaries in online search influence users’ attitudes. arXiv. https://arxiv.org/abs/2511.22809 [本次研究查閱版本 v1。]
附錄:圖表說明
本文圖 1 為構念群共現網絡,圖 2 為紀錄年份的覆蓋率熱圖,圖 3 為不同技術情境的主題演進示意,圖 4 為中介、關聯與調節的角色比較。圖 1 與圖 2 由本次研究的實際編碼計算;圖 3 與圖 4 為有來源依據的語意與模型說明。圖檔另附 SVG 向量格式與 300 dpi PNG;網站可依既有功能提供放大與下載。